Wat is robots.txt? Uitleg in gewoon Nederlands
Robots.txt is een klein tekstbestand op uw website dat zoekmachines en andere crawlers vertelt welke delen van de site ze mogen bezoeken. Een crawler is het programma dat pagina's ophaalt, zoals Googlebot van Google. Zie het als een bordje bij de ingang: nette bezoekers houden zich eraan, maar het is geen slot op de deur.
Waar staat robots.txt?
Robots.txt staat altijd in de hoofdmap van uw website, dus op uwsite.nl/robots.txt. Typ dat adres in uw browser en u ziet meteen of uw site zo'n bestand heeft. Een robots.txt op een andere plek wordt niet gelezen.
Hoe ziet een robots.txt eruit?
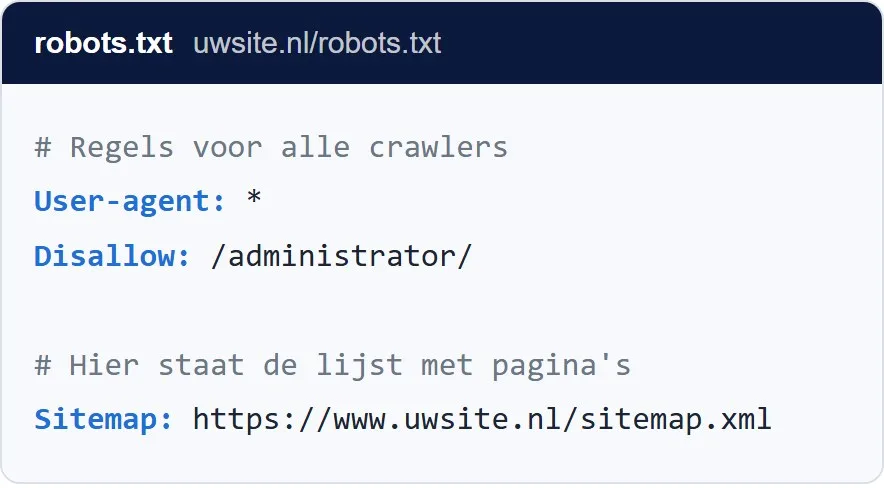
Een robots.txt bestaat uit korte regels die zeggen welke crawler waar niet hoeft te komen. Een eenvoudig voorbeeld:
User-agent: *
Disallow: /administrator/
Sitemap: https://www.uwsite.nl/sitemap.xml
- User-agent zegt voor welke crawler de regels gelden. Het sterretje betekent: voor iedereen.
- Disallow noemt een map of pagina waar de crawler niet hoeft te komen.
- Sitemap vertelt waar de lijst met pagina's van uw site staat.
Kunt u met robots.txt een pagina uit Google houden?
Nee, daar is het bestand niet voor bedoeld. Volgens Google kan een geblokkeerde pagina nog steeds in de zoekresultaten verschijnen, zonder beschrijving. Wilt u een pagina echt uit Google houden, gebruik dan een noindex-instructie of zet er een wachtwoord op. Blokkeer zo'n pagina dan niet ook in robots.txt, anders ziet Google de noindex niet. Meer hierover staat in de uitleg van Google over robots.txt.
Moet u AI-crawlers toestaan of blokkeren?
Dat is uw eigen keuze, en het verschilt per crawler. Bij OpenAI is OAI-SearchBot de crawler voor zoeken in ChatGPT en GPTBot de crawler voor het trainen van modellen. Blokkeert u alleen GPTBot, dan heeft dat volgens OpenAI geen gevolgen voor ChatGPT-zoeken.
Bij Google regelt Google-Extended alleen het gebruik voor training en grounding in andere Google-systemen. Of u in Google en in de AI-overzichten komt, bepaalt Googlebot. Op 4eurohosting.com laten wij de crawlers voor AI-zoeken toe.
Wat gaat er vaak mis met robots.txt?
De bekendste fout is één regel: Disallow: /. Die vraagt crawlers om uw hele site over te slaan. Zo'n regel blijft soms staan nadat een site eerst als testsite is gebouwd. Ook de naam moet kloppen: het bestand moet precies robots.txt heten, met kleine letters.
Hoe controleert u uw robots.txt?
Open uwsite.nl/robots.txt en kijk of er geen Disallow: / staat. De gratis websitecontrole kijkt onder meer welke AI-crawlers uw robots.txt toelaat. In Google Search Console ziet u in het robots.txt-rapport welke versie Google heeft opgehaald en of er fouten in staan.
Hoe u zo'n controle in drie stappen doet, leest u in Technische SEO-audit: uw website analyseren in 3 stappen. Hebt u een vraag over uw eigen site, dan kunt u contact met mij opnemen.
Veelgestelde vragen
Heb ik een robots.txt nodig?
Nee, het is niet verplicht. Zonder dit bestand mogen crawlers uw hele site bezoeken. Handig is het wel, omdat u er ook uw sitemap in kunt noemen.
Houden alle crawlers zich aan robots.txt?
Nee. Googlebot en andere nette crawlers wel, maar niet elke crawler doet dat. Voor gevoelige informatie is een wachtwoord nodig.
Waar pas ik robots.txt aan?
In het bestand robots.txt in de hoofdmap van uw website. Bij hosting met DirectAdmin kan dat via de bestandsbeheerder.
Is robots.txt hetzelfde als een sitemap?
Nee. Robots.txt zegt waar crawlers niet hoeven te komen. Een sitemap is de lijst met pagina's die u gevonden wilt hebben.
Kan robots.txt mijn site uit Google laten verdwijnen?
Ja, dat kan indirect. Met Disallow: / kan Google uw pagina's niet meer lezen, en dat kost u op den duur uw plaatsen.